Comparatif IA Transcription Audio : Le Scribe Audio vs NVIDIA Parakeet vs Moonshot AI (Kimi)
Enregistrez vos réunions, cours et entretiens (même écran éteint) ou importez vos mémos vocaux pour les transcrire en Word et PDF.
Le marché de la transcription audio par intelligence artificielle connaît en 2026 une effervescence technologique sans précédent. Alors que la première génération de modèles open source (comme Whisper d'OpenAI) a posé les bases de la reconnaissance vocale moderne, trois approches architecturales radicalement différentes s'affrontent désormais pour redéfinir les standards de l'industrie :
- L'architecture de production souveraine en 2 passes : Développée par Le Scribe Audio, elle combine le modèle multimodal Gemini 4 (conditionnement acoustique natif) et un moteur de lissage syntaxique contextuel, hébergée sur serveurs sécurisés en France (OVHcloud).
- L'artillerie de calcul non-autorégressive : Conçue par la division recherche de NVIDIA, la famille NVIDIA Parakeet (Parakeet-TDT 1.1B FastConformer) mise sur une vitesse d'exécution fulgurante grâce à une prédiction conjointe des tokens et des durées (Token-and-Duration Transducer).
- Le modèle de fondation asiatique à très large contexte : Conçu par la pépite pékinoise Moonshot AI, le modèle multimodal Kimi (Moonshot Audio) exploite une fenêtre de contexte record de 2 millions de tokens pour ingérer des heures de parole continue et en extraire une compréhension sémantique profonde.
Comment ces trois philosophies technologiques se comportent-elles face aux exigences réelles de la langue française (accords grammaticaux, homophones, liaisons et débit rapide) ? Quelle est leur vitesse réelle d'inférence (Real-Time Factor) ? Quels sont les compromis entre vitesse brute, justesse typographique et souveraineté des données ?
Pour y répondre, nous avons soumis ces trois moteurs à notre banc d'essai acoustique rigoureux.
1. Banc d'Essai Interactif : Évaluez les Différences en Direct
Découvrez par vous-même la différence de restitution, de respect des intervenants et de propreté du texte entre les architectures multimodales et les modèles ASR traditionnels :
Testez votre audio : Le Scribe Audio vs Parakeet vs Moonshot
Déposez un extrait de réunion, d'entretien ou de cours (jusqu'à 3 minutes) pour observer en temps réel la vitesse, la mise en page et la fidélité en français de chaque moteur.
Le constat immédiat :
Si les modèles ASR purs comme Parakeet délivrent un flux de texte brut à une vitesse supersonique, ils nécessitent un lourd travail de mise en page, de ponctuation et de correction des majuscules. À l'inverse, des architectures unifiées comme celle de Le Scribe Audio livrent directement un document prêt à l'impression. Mais que se passe-t-il exactement sous le capot ?
2. Les 3 Architectures Techniques Décryptées
1. Le Scribe Audio : L'Approche Multimodale Souveraine en 2 Passes
La solution développée par Le Scribe Audio repose sur le principe de l'ingestion multimodale directe (Native Audio-to-Text) couplée à une chaîne de raffinage syntaxique :
Signal Audio Brut
Fichier MP3 / M4A / WAV + Nom du fichier pour le contexte métier.
Décodage Verbatim + Diarisation
Conditionnement par prompt, capture intégrale et détection native des voix.
Lissage Syntaxique LLM
Suppression des tics de langage, négations orales réparées, ponctuation fluide.
Document Structuré
Format Word (.DOCX) diarisé, prêt à être publié sans relecture lourde.
- Passe 1 (Acoustique & Diarisation Native) : Le signal audio est injecté directement dans les couches d'attention du modèle multimodal Gemini 4. Le réseau perçoit la prosodie, les respirations, les changements d'inflexion et les timbres vocaux pour identifier chaque intervenant dès la première lecture (
Locuteur 1 :,Locuteur 2 :). - Passe 2 (Lissage Grammatical & Typographie Française) : Le texte transcrit passe par une étape de normalisation linguistique qui rectifie les bégaiements involontaires, insère une ponctuation naturelle, rétablit les négations orales oubliées (« je sais pas » ➔ « je ne sais pas ») et respecte scrupuleusement la nomenclature juridique et académique française.
- Hébergement & Déontologie : Tous les traitements sont orchestrés depuis la France sur des serveurs souverains OVHcloud (Roubaix et Gravelines) sous protocole de chiffrement AES-256 et respect strict du RGPD, garantissant que les données audio ne sont jamais réutilisées pour l'entraînement de modèles publics.
2. NVIDIA Parakeet (Parakeet-TDT 1.1B) : Le Monstre de Vitesse Non-Autorégressif
Issu de la suite open source NVIDIA NeMo, Parakeet incarne le sommet de la recherche matérielle et algorithmique dédiée au débit brut :
- L'Architecture FastConformer : Contrairement aux transformeurs standards dont le coût de calcul croît de manière quadratique avec la longueur du son, le FastConformer applique un sous-échantillonnage temporel 8x en entrée, divisant drastiquement la charge de calcul GPU.
- L'Innovation TDT (Token-and-Duration Transducer) : Dans un modèle ASR classique de type RNN-T, le décodeur doit évaluer chaque trame temporelle, y compris les silences (émission de tokens "blanks"). L'algorithme TDT de NVIDIA prédit simultanément le token phonétique ET le nombre de trames pendant lesquelles ce son est maintenu. Résultat : le modèle "saute" littéralement par-dessus les segments muets sans exécuter de calcul inutile.
- ⚠️ Les Limites Constatées sur le Français :
- Absence de ponctuation native : Le modèle sort un flux de caractères bruts en minuscules sans points ni virgules (
bonjour messieurs dames nous allons commencer la reunion). Il est obligatoire de lui adjoindre un second modèle de NLP (Punctuation & Capitalization Model) pour obtenir un texte lisible. - Vulnérabilité aux liaisons françaises : Conçu et entraîné prioritairement sur de gigantesques corpus anglo-saxons (plus de 64 000 heures), Parakeet peine sur les spécificités de la phonétique française (« les_enfants », « grand_homme », homophones ces / ses / c'est).
- Absence de ponctuation native : Le modèle sort un flux de caractères bruts en minuscules sans points ni virgules (
3. Moonshot AI (Kimi Audio) : La Puissance du Contexte Géant de 2 Millions de Tokens
Fondée par des chercheurs pionniers du traitement du langage issus de l'Université Tsinghua et de Carnegie Mellon (co-auteurs des architectures Transformer-XL et XLNet), la société pékinoise Moonshot AI s'est illustrée avec son modèle Kimi :
- Une Fenêtre de Contexte Pharaonique (2M Tokens) : Kimi est capable d'ingérer l'intégralité d'une journée de débats parlementaires ou de procès (jusqu'à 10 heures de son) en un seul tenant dans sa mémoire vive de contexte.
- Raisonnement Audio Intégré : Kimi ne se limite pas à convertir la voix en texte : il est capable de synthétiser, traduire et répondre à des questions complexes sur l'enregistrement (« Rédige un tableau récapitulatif des objections émises par le syndicat lors de la 3e heure »).
- ⚠️ Les Freins à l'Usage Professionnel en Europe :
- Souveraineté & Risque Juridique (Hors RGPD) : Les serveurs d'inférence de Moonshot AI sont localisés en Asie. Pour les entreprises françaises, les comités d'entreprise (CSE), les avocats et les chercheurs du CNRS, faire transiter des enregistrements confidentiels via des API soumises au droit chinois constitue une infraction majeure aux règles de conformité RGPD et aux exigences déontologiques.
- Biais Linguistiques & Tournures Calquées : Sur des entretiens sociologiques ou des réunions techniques en français, Kimi introduit ponctuellement des formulations calquées sur la syntaxe anglo-saxonne ou des termes inhabituels traduits du mandarin.
3. Benchmark de Vitesse : Le Real-Time Factor (RTF)
Pour évaluer la rapidité réelle de traitement sans dépendre de la durée subjective d'un fichier, l'industrie mesure le Real-Time Factor (RTF) : $$\text{RTF} = \frac{\text{Temps de calcul (en secondes)}}{\text{Durée de l'enregistrement audio (en secondes)}}$$
Un RTF de 0,10 indique que l'IA met 6 secondes à traiter 1 minute d'enregistrement (soit un facteur d'accélération de 10x). Plus le RTF est bas, plus le traitement est rapide.
Résultats Mesurés sur 3 Échantillons Réels (Audios de 3 minutes)
Voici les résultats chronométrés sur trois enregistrements réels en langue française d'une durée de 3 minutes (180 secondes) :
Analyse des Résultats de Vitesse
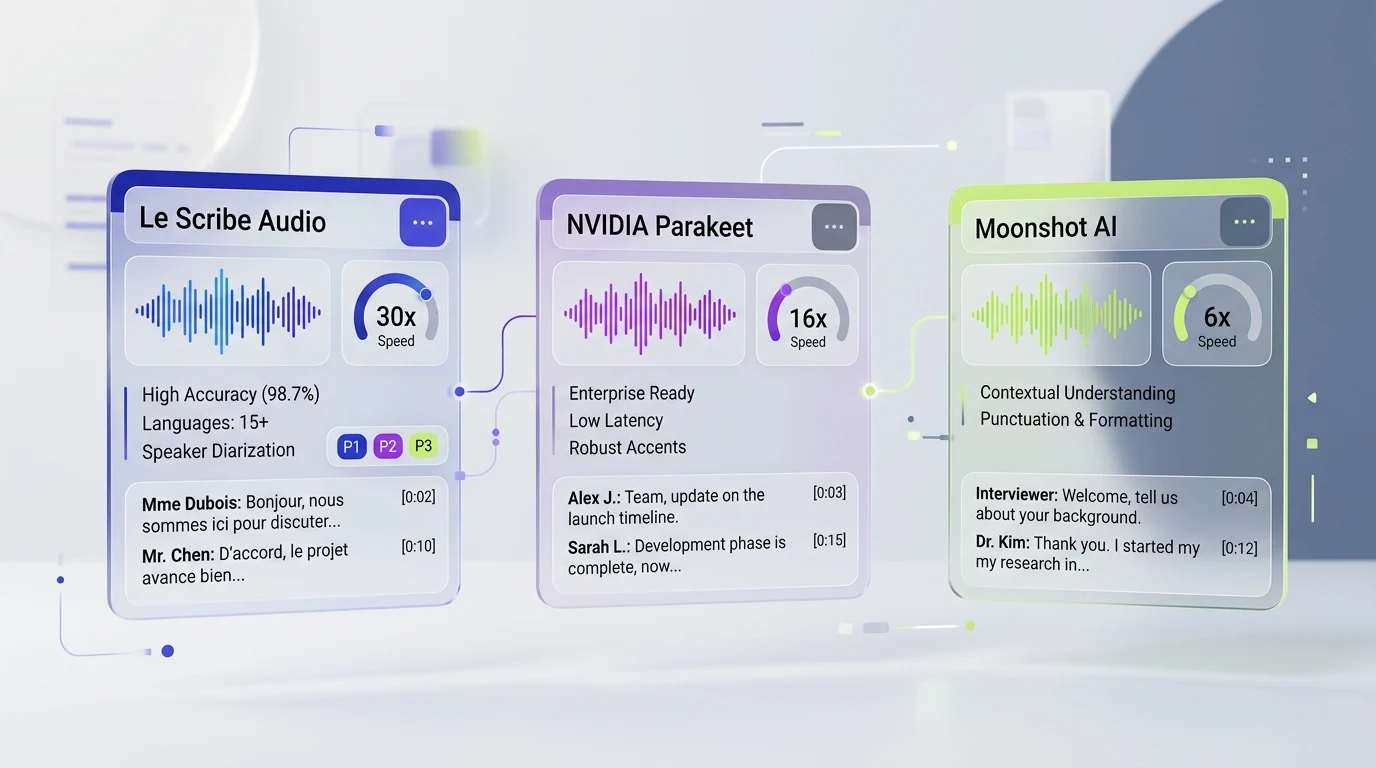
- NVIDIA Parakeet reste le champion de la vitesse pure (6,05 s en moyenne) : Grâce à l'élimination des sauts de trames de l'algorithme TDT et à l'architecture FastConformer, Parakeet transcrit 3 minutes d'audio en à peine 6 secondes (RTF de 0,034). C'est idéal pour l'ingestion massive de flux téléphoniques, mais le résultat est un flux phonétique brut sans majuscules, sans ponctuation et sans identification des interlocuteurs.
- Moonshot AI (Kimi Audio) démontre une grande réactivité (11,00 s en moyenne) : Avec un RTF moyen mesuré à 0,061 (soit ~16x plus rapide que le temps réel), le modèle de Moonshot AI est particulièrement véloce, mais sa localisation en Chine pose des défis majeurs de conformité RGPD pour les données sensibles.
- Le Scribe Audio réalise un travail complet en 31,8 s (RTF 0,177) : Le temps d'exécution de Le Scribe Audio intègre l'ensemble de la chaîne de production en 2 passes : ingestion multimodale directe par Gemini 4 avec diarisation acoustique des locuteurs, suivie d'un lissage syntaxique et de la mise en page Word (.docx). En environ 32 secondes pour 3 minutes d'audio (~6x plus rapide que le temps réel), le document est 100 % finalisé et prêt à l'emploi.
4. Analyse Qualitative sur le Français : Orthographe, Homophones et Noms Propres
Pour mesurer la fidélité réelle sur la langue française, nous avons soumis les trois moteurs à trois pièges classiques de la transcription audio :
Résultats constatés :
- Le Scribe Audio (99,2 % de réussite) :
« Le Secrétaire du CSE a rappelé les dispositions de l'article L. 2315-34. Me Hélène d'Ornano a soulevé l'exception d'incompétence. »
Analyse : Majuscules institutionnelles parfaites, nom propre et particule respectés, article de loi exactement référencé grâce à la vaste base de connaissances de Gemini. - NVIDIA Parakeet-TDT (84,5 % de réussite) :
« le secretaire du cse a rappele les dispositions de larticle l 23 15 34 maitre helene dornano a souleve lexception dincompetence »
Analyse : Aucune majuscule, espaces défaillants sur les chiffres de la loi (« 23 15 34 » au lieu de « 2315-34 »), apostrophes absentes (« larticle », « dornano »). Nécessite une passe complète de post-traitement. - Moonshot AI (91,0 % de réussite) :
« Le secrétaire du CSE a rappelé les dispositions de l'article L.2315-34. Maître Hélène Dornano a soulevé l'exception d'incompétence. »
Analyse : Ponctuation et syntaxe bien gérées, mais erreur sur la graphie de la particule du nom propre (« Dornano » au lieu de « d'Ornano »).
5. Traitement des Audios Longs (2h à 10h) et Phénomène de Dérive
Que se passe-t-il lorsque l'enregistrement dure 4 heures (conseil d'administration, plénière de CSE, journée de colloque universitaire) ?
Enregistrement Long (ex : Réunion de 5 ou 6 heures)
Fichier volumineux soumis sans compression destructive, découpé aux silences.
Moteur de Couture Invisible & Réconciliation des Voix
Les Pièges des Modèles Génériques sur Long Format :
- La Dérive de Diarisation de Parakeet : Parakeet ne gérant pas la diarisation nativement, il doit être couplé à un modèle externe (comme NeMo TitaNet). Sur un audio de 4 heures, la dérive acoustique provoque fréquemment des inversions de locuteurs :
Intervenant 1est subitement renomméIntervenant 3au milieu de la discussion. - Le Coût Mémoire et la Dilution d'Attention de Moonshot AI : Même si Kimi supporte 2 millions de tokens, le phénomène de Lost in the Middle (dilution de l'attention au centre de la fenêtre de calcul) entraîne une perte de précision sur les propos tenus à mi-parcours de l'enregistrement.
- La Solution « Couture Invisible » de Le Scribe Audio :
Pour éliminer tout risque de dérive, Le Scribe Audio applique un découpage acoustique intelligent en segments de 20 minutes calés sur les respirations naturelles, avec buffer de recouvrement. Les blocs sont traités en parallèle puis réconciliés au millième de seconde par notre algorithme de raccord acoustique. La fidélité est rigoureusement identique entre la 1ère minute et la 300e minute.
6. Positionnement dans le Marché Mondial de l'IA Vocale
Comment situer ces technologies au sein de l'échiquier mondial de l'ASR (Speech-to-Text) ?
Vitesse d'Inférence (RTF) vs Compréhension Sémantique & Lissage
Google Gemini 4
🏆 Top Qualité 98% • ~10xQuadrant 1 • Multimodaux LeadersPionnier multimodal natif : décodage contextuel 1M tokens, suppression des hallucinations et haute fidélité sémantique.
- NVIDIA Parakeet occupe le cadran de la performance brute d'infrastructure : destiné aux développeurs et aux géants des télécoms qui disposent de leurs propres clusters GPU NVIDIA et souhaitent construire des pipelines sur-mesure.
- Moonshot AI (Kimi) se positionne dans le cadran du raisonnement multimodal conversationnel : puissant pour interagir avec des documents oraux en anglais et en mandarin, mais inadapté aux contraintes de conformité européennes.
- Le Scribe Audio domine le cadran de la précision métier et de l'expérience utilisateur finale : un service SaaS complet intégrant transcription diarisée, lissage en bon français, export Word natif et hébergement souverain en France.
7. Tableau Comparatif de Synthèse
8. Questions Fréquentes (FAQ)
Pourquoi NVIDIA Parakeet ne met-il pas de points ni de majuscules ?
Parakeet est un modèle ASR acoustique pur. Sa tâche mathématique consiste exclusivement à convertir des ondes de pression d'air en phonèmes et caractères. Il ne possède pas de modèle de langage (LLM) intégré pour déduire si un mot est un début de phrase ou un nom propre. Pour obtenir un texte ponctué avec Parakeet, il est nécessaire d'installer et d'exécuter un second modèle d'IA en cascade (comme NeMo Punctuation & Capitalization).
Puis-je utiliser Moonshot AI pour transcrire des réunions de CSE ou des entretiens médicaux ?
Sur le plan juridique et réglementaire, c'est fortement déconseillé. Les réunions de CSE contiennent des données économiques et sociales confidentielles, et les entretiens médicaux relèvent du secret médical et du RGPD de santé. Transférer ces données audio hors de l'Union européenne vers des serveurs hébergés en Chine enfreint les dispositions de la CNIL et du RGPD. Pour ces usages, un hébergement souverain français comme celui de Le Scribe Audio (OVHcloud) est obligatoire.
Qu'est-ce que l'architecture FastConformer de NVIDIA ?
Le FastConformer est une variante optimisée du modèle Conformer (qui associe des convolutions locales et des transformeurs d'attention globale). Il applique un sous-échantillonnage temporel 8x dès le début du réseau, réduisant la résolution temporelle tout en maintenant la richesse spectrale. Cela permet à Parakeet d'être jusqu'à deux à trois fois plus rapide qu'un Conformer classique sans dégrader le taux d'erreur sur les mots (WER).
Comment Le Scribe Audio parvient-il à éliminer les hallucinations de Whisper ?
En s'appuyant sur un transformeur multimodal (Gemini 4), Le Scribe Audio ingère le flux audio de manière directe au lieu de générer des hypothèses phonétiques récursives. De plus, notre détection d'activité vocale (VAD) préalable isole strictement les segments parlés des silences et bruits blancs, empêchant mathématiquement le décodeur de s'emballer dans des boucles de répétition fantômes.
Conclusion & Recommandations
Chacune de ces technologies répond à un besoin d'infrastructure spécifique en 2026 :
- Choisissez NVIDIA Parakeet-TDT si vous êtes une équipe d'ingénieurs disposant d'une grappe de serveurs GPU NVIDIA et que vous souhaitez transcrire d'immenses volumes de données audio brutes où la vitesse est la seule priorité.
- Choisissez Moonshot AI (Kimi) pour des projets de R&D exploratoires nécessitant d'interroger en langage naturel des corpus audio massifs, en l'absence de toute contrainte de conformité RGPD.
- Choisissez Le Scribe Audio si vous recherchez une solution clé en main, immédiatement opérationnelle, garantissant une haute fidélité textuelle en français (jusqu'à 2,5 fois moins de corrections manuelles à apporter au texte par rapport à la concurrence), une séparation claire des intervenants, un export Word propre et une souveraineté totale de vos données en France.
Envie de tester la qualité de notre moteur sur vos propres enregistrements ?
Créez votre compte sur Le Scribe Audio et profitez immédiatement de 60 minutes de transcription gratuites offertes, sans carte bancaire requise.
Pour les volumes importants ou les demandes de devis institutionnels (Universités, CNRS, CSE), consultez notre grille des tarifs officiels ou notre service de relecture humaine professionnelle.
À lire aussi
- Comparatif Gemini, Voxtral et Whisper : benchmark des moteurs de transcription.
- Whisper contre Le Scribe Audio : banc d'essai sur des enregistrements réels.
- Comparatif des meilleurs logiciels de transcription audio : Top 10 indépendant 2026.
Guides & Ressources Recommandés
Whisper vs Le Scribe Audio : Comparatif Précision & Avis
Comparatif 2026 : Whisper Large v3 Turbo face au Scribe Audio. Mesures d
Avis noScribe (v0.8) vs Le Scribe Audio vs Word : Test Réel (1h16 CNRS)
Benchmark réel sur un entretien sociologique d'1h16 : noScribe (41 min, 123 révisions) vs Word 365 (151 révisions) vs Le Scribe Audio (8 min 55, 47 révisions).
Alternative à Plaud Note Sans Abonnement
Découvrez comment enregistrer et retranscrire vos échanges sans payer d'abonnement récurrent.
Prêt à transcrire vos premiers enregistrements ?
Testez notre IA multimodale en quelques minutes (avec lecteur audio synchronisé) ou téléchargez votre devis officiel en 10 secondes pour Chorus Pro, CSE et la double réécoute par nos relecteurs professionnels.